Lab 06 : Exploitation, Observabilité & Reverse Debugging
Objectifs Pédagogiques :
- Configurer les sondes de santé indispensables : Liveness Probe et Readiness Probe.
- Maîtriser l'extraction et le filtrage des logs d'application (
kubectl logsen direct et historique de crash). - Diagnostiquer et réparer méthodiquement 3 incidents de production classiques :
- Panne 1 :
CrashLoopBackOff(erreur applicative au démarrage) - Panne 2 :
OOMKilled(dépassement de quota mémoire) - Panne 3 :
Endpoints vides / Pod Not Ready(échec de probe) - Détecter, analyser et remédier aux pannes du noyau Linux avec Node Problem Detector (NPD) (simulation d'erreur kmsg, inspection d'événements et mise en quarantaine
kubectl cordon/drain). - Déployer et exploiter la chaîne complète d'observabilité CNCF en production :
- Métriques temps réel : Metrics-Server (
kubectl top nodes,kubectl top pods) - Collecte et expédition de logs : Fluent Bit (DaemonSet)
- Moteur d'indexation des logs : Loki
- Métriques et séries temporelles : Prometheus
- Tableaux de bord unifiés et requêtes LogQL : Grafana
📌 Note Compatibilité OS :
Les commandes d'investigation (kubectl logs -f,kubectl describe,kubectl top,kubectl cordon,kubectl port-forward) sont rigoureusement identiques sous Windows (PowerShell), Linux (Ubuntu) et macOS (Terminal).💡 Modalités d'exécution (Au choix) :
Option A (Recommandée - Confort DevOps Local) : Exécutez vos commandeskubectl, investigations et consultations de tableaux de bord directement depuis votre poste local.
Option B (Secours - PC d'entreprise verrouillé) : Connectez-vous en SSH surk8s-controloù les manifests et outils sont prêts à l'emploi (seule la simulation d'erreur kernel dans l'Exercice 2 requiert une commande directe sur le worker).
Contexte Métier
En tant qu'administrateur Kubernetes ou ingénieur SRE, plus de 70% de votre temps d'exploitation consiste à comprendre pourquoi un conteneur ne démarre pas, pourquoi il redémarre en boucle, pourquoi il ne reçoit aucun trafic utilisateur ou quel processus sature la mémoire du serveur. Cet atelier vous entraîne aux réflexes d'investigation méthodique en situation d'incident réel et vous guide dans le déploiement de la pile d'observabilité complète de référence de la Cloud Native Computing Foundation (CNCF).
Exercice 1 : Configurer Liveness & Readiness Probes
1. Pourquoi différencier ces deux sondes ?
- Liveness Probe : "L'application est-elle vivante ?"
Si elle échoue, Kubernetes tue et redémarre le conteneur pour tenter de restaurer le service. - Readiness Probe : "L'application est-elle prête à recevoir du trafic utilisateur ?"
Si elle échoue, Kubernetes retire immédiatement le pod des Endpoints du Service sans le redémarrer (aucun client n'est envoyé vers lui).
2. Injecter les sondes dans le backend
Modifiez votre fichier deployment-backend.yaml pour ajouter ces sondes sur l'endpoint Actuator Spring Boot /actuator/health (port 8080) :
apiVersion: apps/v1
kind: Deployment
metadata:
  name: campus-backend
spec:
  replicas: 2
  selector:
    matchLabels:
      app: campus-backend
  template:
    metadata:
      labels:
        app: campus-backend
    spec:
      containers:
      - name: backend
        image: regaieg/campus:backend-1.0.0
        ports:
        - containerPort: 8080
        livenessProbe:
          httpGet:
            path: /actuator/health
            port: 8080
          initialDelaySeconds: 60
          periodSeconds: 10
          failureThreshold: 3
        readinessProbe:
          httpGet:
            path: /actuator/health
            port: 8080
          initialDelaySeconds: 25
          periodSeconds: 5
Appliquez le manifest et observez la colonne READY lors du démarrage :
0/1 pendant la phase de démarrage de Spring Boot (initialDelaySeconds: 25s), puis passe à 1/1 dès que la Readiness Probe répond HTTP 200 OK !
Exercice 2 : La Boîte à Outils du Debugging & Filtrage des Logs
Exercez-vous sur ces commandes fondamentales de l'exploitation en production :
1. Suivi des logs en temps réel (Streaming)
Affichez les 50 dernières lignes de log du backend et suivez les nouvelles arrivées :
(Appuyez surCtrl + C pour quitter le mode streaming).
2. Affichage avec préfixe multi-pods
Lorsque vous avez plusieurs réplicas, l'option --prefix=true permet de distinguer la source exacte de chaque message :
3. Investigation post-mortem : Les logs du crash précédent
Si un conteneur a planté et vient de redémarrer, ses logs actuels sont vides ou réinitialisés. L'option --previous permet de lire la mémoire tampon du conteneur juste avant sa destruction :
4. Chronologie des événements du cluster
Affichez les événements récents classés par ordre chronologique d'apparition :
Exercice 3 : Atelier Reverse Debugging - Résolution de 3 Incidents Réels
Dans cet exercice, nous déclenchons 3 pannes volontaires caractéristiques des environnements d'entreprise. Votre objectif est d'appliquer la démarche de diagnostic en 3 étapes : kubectl get → kubectl describe → kubectl logs.
Incident A : Redémarrage en boucle applicatif (CrashLoopBackOff)
-
Déployez un conteneur configuré pour échouer immédiatement après son démarrage :
-
Observez le statut du pod :
Le pod passe deRunningàError, puis bascule enCrashLoopBackOffavec le compteur de redémarrages qui s'incrémente. -
Investigation méthodique :
Examinez la sectionLast State: Terminated: vous identifiezExit Code: 42. Un code différent de 0 signifie que le processus principal s'est arrêté sur une erreur fatale. -
Affichez les logs avant le crash pour lire le message d'erreur :
Vous lisez immédiatement :Erreur fatale code 42. -
Nettoyez l'incident :
Incident B : Dépassement de seuil mémoire (OOMKilled)
-
Déployez un conteneur avec une limite mémoire bridée à 10 Mo (
10Mi) exécutant un processus qui tente d'en allouer 50 Mo : -
Surveillez le pod :
-
Investigation méthodique :
Dans la sectionLast State: Terminated, observez la mention explicite :Reason: OOMKilled.
Le noyau Linux (via les cgroups) a déclenché l'OOM Killer car le processus a franchi la barrière physique infranchissable définie danslimits.memory. -
Nettoyez l'incident :
Incident C : Échec de sonde de disponibilité (Pod Not Ready)
-
Déployez un serveur web dont la readiness probe pointe vers une route inexistante (
/api/inexistant) qui renverra un code HTTP 404 : -
Observez le statut :
Le pod reste indéfiniment à l'état0/1bien qu'il soit marquéRunning! -
Investigation méthodique :
Consultez la liste des événements en bas :Warning Unhealthy readiness probe failed: HTTP probe failed with statuscode: 404
Conséquence directe : si un Service ciblait ce pod, l'objet Endpoints resterait vide et aucun utilisateur ne pourrait y accéder.
- Nettoyez l'incident :
Exercice 4 : Détection Avancée de Pannes Noyau & Système avec Node Problem Detector (NPD)
1. Contexte & Architecture de NPD
Par défaut, le kubelet ne surveille qu'un ensemble très restreint de métriques du serveur hôte : la mémoire disponible, l'espace disque et le nombre de processus (PIDPressure).
Le Piège Silencieux : Si le système d'exploitation du serveur worker subit une panne sous-jacente grave :
1. Kernel Deadlock : Un bug de thread système fige une partie des opérations du processeur.
2. Read-only Filesystem : À la suite d'un problème sur le disque SSD ou EBS, le noyau Linux monte le système de fichiers en lecture seule pour protéger les données (remount-ro).
3. Container Runtime Unresponsive : Le démon containerd freeze sans que son processus ne soit formellement arrêté.
Dans ces situations, le kubelet peut continuer à répondre « Ready=True » à l'API Server. Le scheduler continue d'envoyer de nouveaux pods vers ce serveur malade, causant des pannes en cascade !
flowchart TD
    subgraph Host["Nœud Worker (Hôte Linux)"]
        Kernel["Journaux Noyau Linux<br/>(/dev/kmsg / journald)"] --> NPD["Node Problem Detector<br/>(DaemonSet NPD)"]
        FS["Système de Fichiers & I/O"] --> NPD
    end

    NPD -->|"Injecte NodeConditions<br/>(KernelDeadlock, ReadonlyFilesystem)"| ApiServer["Kubernetes API Server"]
    ApiServer --> Admin["Ingénieur SRE / Auto-Repair"]
    Admin -->|"kubectl cordon + drain"| SafeCluster["Nœud Isolé & Pods Déplacés vers Serveurs Sains"]
2. Décryptage sous le Capot : L'Anatomie du Manifeste npd.yaml
Avant d'appliquer le fichier, ouvrons la boîte noire pour comprendre son architecture interne :
- Pourquoi un
DaemonSetet non unDeployment?
UnDeploymentordonnance des pods où il le souhaite selon les ressources disponibles. NPD, lui, ne surveille pas du code applicatif : il surveille le matériel et le système d'exploitation du serveur hôte. Il doit donc obligatoirement exécuter exactement une instance par machine physique, ce qui est la définition même d'unDaemonSet. - L'accès bas niveau via volume
hostPathet mode privilégié :Pour intercepter les alertes critiques émises par le noyau Linux (deadlock, disque corrompu en lecture seule), le conteneur monte directement le pseudo-fichiersecurityContext: privileged: true volumeMounts: - name: kmsg mountPath: /dev/kmsg readOnly: true volumes: - name: kmsg hostPath: path: /dev/kmsg/dev/kmsgdu serveur hôte et requiert le drapeauprivileged: true. - Le moteur de détection par expressions régulières (ConfigMap) :
La ConfigMapnode-problem-detector-configinjecte les règles de filtrage regex surveillées dans les logs système (ex:BUG: unable to handle kernel NULL pointer dereference,Kernel panic,Task blocked for more than 120 seconds). - L'injection de conditions dans l'API Server (RBAC) :
NPD utilise unServiceAccountlié à unClusterRoleavec les droitspatchsur la ressourcenodes/status. Dès qu'une panne noyau est détectée, NPD appelle directement l'API Server pour faire basculer la condition du nœudKernelDeadlock=Trueet émettre unEventKubernetes.
3. Déploiement Complet de Node Problem Detector
Appliquez le manifest :
Vérifiez que les pods NPD sont actifs sur vos nœuds :
kubectl get daemonset -n kube-system node-problem-detector
kubectl get pods -n kube-system -l app=node-problem-detector -o wide
Observez les conditions enrichies de votre nœud :
kubectl describe node $(kubectl get nodes -o jsonpath='{.items[0].metadata.name}') | grep -A 25 "Conditions:"
KernelDeadlock=False, ReadonlyFilesystem=False.
4. Simulation Active d'une Panne Noyau
Simulons une anomalie critique du noyau Linux en écrivant le motif d'erreur exact surveillé par NPD (BUG: unable to handle kernel NULL pointer dereference) :
-
Méthode universelle (via conteneur privilégié d'injection kmsg) :
-
Méthode directe (si accès SSH au nœud worker) :
5. Constat de Détection et Réflexe SRE : Mise en Quarantaine (cordon)
-
Surveillez les événements générés par NPD dans le cluster :
NPD a intercepté l'erreur du noyau et a généré un événement d'avertissement dans le cluster ! -
Réflexe SRE de protection immédiat (Mise en Quarantaine) :
Pour empêcher tout nouveau déploiement sur ce serveur instable, isolez-le immédiatement :Le nœud affiche le statutNODE_NAME=$(kubectl get nodes -o jsonpath='{.items[0].metadata.name}') kubectl cordon $NODE_NAME kubectl get nodesReady,SchedulingDisabled! Le cluster est protégé contre toute nouvelle assignation. -
Évacuation préventive des charges saines : Pour déplacer les pods applicatifs déjà en cours d'exécution sur ce serveur vers d'autres nœuds sains :
-
Rétablissez le nœud pour la suite de nos travaux :
Exercice 5 : La Chaîne Complète d'Observabilité CNCF
En production Kubernetes moderne, l'observabilité repose sur le triptyque Métriques (Metrics-Server & Prometheus), Collecte de Logs (Fluent Bit), Stockage & Indexation (Loki) et Visualisation Unifiée (Grafana).
flowchart LR
    subgraph Host["Nœud Hôte Worker"]
        App["Pod campus-backend<br/>(stdout / stderr)"] --> Disk["/var/log/pods/*.log"]
        FB["Fluent Bit<br/>(DaemonSet)"] -->|Lecture disque| Disk
        Kubelet["Kubelet / cAdvisor<br/>(Métriques CPU/RAM)"]
    end

    subgraph Monitoring["Namespace monitoring"]
        MS["Metrics-Server<br/>(kubectl top)"]
        Loki["Loki<br/>(Moteur d'indexation Logs)"]
        Prom["Prometheus<br/>(Séries Temporelles)"]
        Grafana["Grafana<br/>(Tableaux de Bord Unifiés)"]
    end

    Kubelet -->|Scrape /metrics| Prom
    Kubelet -->|Métriques brutes| MS
    FB -->|Push HTTP 3100| Loki
    Prom -->|DataSource PromQL| Grafana
    Loki -->|DataSource LogQL| Grafana
1. Décryptage Architectural des Manifests (Ouvrons la Boîte Noire !)
Ne déployons pas ces fichiers à l'aveugle. Analysons les choix d'ingénierie Kubernetes qui composent ces 6 manifests :
| Fichier | Type d'Objet Kubernetes | Rôle Technique & Clé de Compréhension |
|---|---|---|
00-namespace.yaml |
Namespace |
Isolation du plan d'observabilité : Cloisonne toute la pile dans monitoring pour ne pas impacter les quotas et réseaux des applications métiers (campus-dev, campus-prod). |
01-metrics-server.yaml |
Deployment + ClusterRole |
Alimentation de kubectl top et du HPA : Scrape les métriques CPU/RAM instantanées. Contient l'argument --kubelet-insecure-tls car Kubeadm utilise des certificats TLS auto-signés sur le port 10250 du kubelet. |
02-loki.yaml |
Deployment + ConfigMap + Service |
Moteur d'indexation ultra-léger : Contrairement à Elasticsearch qui indexe chaque mot du log (gourmand en RAM), Loki n'indexe que les étiquettes (app, pod, namespace) et stocke le texte brut compressé sur disque. Port d'écoute : 3100. |
03-fluentbit.yaml |
DaemonSet + ClusterRole + ConfigMap |
Collecteur et enrichisseur de logs (voir détail ci-dessous). |
04-prometheus.yaml |
Deployment + ClusterRole + ConfigMap |
Base de données de séries temporelles (voir détail ci-dessous). |
05-grafana.yaml |
Deployment + ConfigMap + Service NodePort |
Visualisation unifiée en GitOps (voir détail ci-dessous). |
Gros Plan : Comment fonctionne le pipeline Fluent Bit (03-fluentbit.yaml) ?
Fluent Bit est le composant le plus sophistiqué de la chaîne. Pourquoi est-il un DaemonSet ? Parce qu'il doit collecter les logs sur le disque de chaque machine hôte :
[Fichier sur disque hôte]          [Pipeline interne Fluent Bit]             [Destination]
/var/log/containers/*.log  ──>  [INPUT: tail (CRI Parser)]
                                         │
                                         ▼
                                [FILTER: kubernetes]  <───> [Kubernetes API Server]
                                (Injecte app, pod, ns)      (Requête via ServiceAccount/ClusterRole)
                                         │
                                         ▼
                                [OUTPUT: loki:3100]   ───>  [Loki Ingestion API]
- Le filtre Kubernetes : Le fichier sur disque se nomme par exemple
campus-backend_campus-dev_c2a...log. Grâce à sonClusterRole, Fluent Bit interroge l'API Server pour identifier les labels réels du pod (app=campus-backend,env=dev). C'est cette étape qui permet ensuite de filtrer{app="campus-backend"}dans Grafana ! - L'exclusion anti-boucle :
Exclude_Path /var/log/containers/*fluent-bit*.logempêche Fluent Bit de collecter ses propres logs (ce qui saturerait le cluster en boucle infinie).
Gros Plan : Comment Prometheus découvre-t-il les métriques (04-prometheus.yaml) ?
Dans la ConfigMap de Prometheus :
* Auto-discovery (kubernetes_sd_configs) : Prometheus demande à l'API Server la liste des nœuds disponibles sans qu'aucune adresse IP ne soit codée en dur.
* cAdvisor : Prometheus contacte chaque kubelet sur le port 10250 pour interroger l'agent cAdvisor (Container Advisor) intégré au moteur de conteneurs. C'est de là que proviennent les métriques container_cpu_usage_seconds_total et container_memory_working_set_bytes.
Gros Plan : Pourquoi Grafana est-il configuré automatiquement (05-grafana.yaml) ?
Dans les déploiements professionnels, on ne clique jamais dans l'interface pour ajouter une base de données.
Le fichier 05-grafana.yaml injecte un ConfigMap monté dans /etc/grafana/provisioning/datasources/datasources.yaml :
datasources:
  - name: Prometheus
    url: http://prometheus.monitoring.svc:9090
  - name: Loki
    url: http://loki.monitoring.svc:3100
NodePort: 30300 pour un accès direct depuis votre navigateur.
2. Déploiement de la Pile de Supervision en 1 Commande
Appliquez les manifests préparés situés dans le dossier monitoring/ :
kubectl apply -f monitoring/00-namespace.yaml
kubectl apply -f monitoring/01-metrics-server.yaml
kubectl apply -f monitoring/02-loki.yaml
kubectl apply -f monitoring/03-fluentbit.yaml
kubectl apply -f monitoring/04-prometheus.yaml
kubectl apply -f monitoring/05-grafana.yaml
Attendez que l'ensemble des composants soient à l'état Running :
fluent-bit, grafana, loki, prometheus et metrics-server tous opérationnels !)
3. Cas d'Usage Métriques : Mesure en Direct avec kubectl top
Interrogez l'utilisation processeur et mémoire globale des serveurs :
Vous obtenez la charge CPU (en millicoresm) et mémoire (en Mi) pour chaque machine !
Interrogez l'utilisation de vos pods applicatifs :
Crash-Test de Surcharge CPU :
-
Démarrez un conteneur qui sature volontairement 1 cœur de calcul processeur à 100% :
-
Patientez 15 secondes (cycle d'échantillonnage de Metrics-Server), puis observez :
Vous observez immédiatement quecpu-stresserconsomme près de 1000m (1 cœur CPU entier) !
C'est exactement grâce à cette métrique que le contrôleur Horizontal Pod Autoscaler (HPA) décide d'ajouter automatiquement de nouveaux réplicas en production. -
Supprimez le conteneur de stress :
4. Cas d'Usage Logs : La Chaîne de Collecte Fluent Bit & Loki
-
Inspectez les logs de Fluent Bit pour constater qu'il a automatiquement détecté les flux de conteneurs de votre cluster :
Vous devez voir des mentions confirmant la connexion réussie versloki.monitoring.svc:3100. -
Générez du trafic applicatif sur le backend :
5. Cas d'Usage Visualisation : Tableaux de Bord Unifiés Grafana
Sur votre cluster AWS multi-nœuds déployé au Lab 00, le service Grafana est exposé via son Service NodePort sur le port 30300 :
- Récupérez l'adresse IP publique de votre nœud worker
k8s-worker-1(notée dans votre session MobaXterm ou console AWS). - Ouvrez votre navigateur web à l'adresse :
http://<IP_PUBLIQUE_WORKER>:30300. (Alternative via tunnel direct :kubectl port-forward --address 0.0.0.0 svc/grafana 3000:3000 -n monitoringsurhttp://<IP_PUBLIQUE_CONTROL>:3000). - Connectez-vous avec les identifiants configurés :
- Identifiant :
admin -
Mot de passe :
admin2026 -
Explorer les Sources de Données Pré-configurées :
- Rendez-vous dans le menu Connections → Data sources.
-
Constatez que Prometheus (métriques) et Loki (logs) sont déjà configurés et opérationnels !
-
Interroger les Logs Applicatifs avec LogQL (Loki) :
- Cliquez sur le menu Explore (boussole à gauche) et sélectionnez la source Loki.
- Dans le champ de requête, saisissez :
- Cliquez sur Run query en haut à droite : Vous voyez s'afficher en direct les logs Spring Boot de votre application, horodatés et étiquetés avec les métadonnées Kubernetes (pod, conteneur, namespace) !
-
(Astuce de formatage direct) : Pour afficher les logs de tous les conteneurs sous forme de texte clair épuré (sans les accolades JSON), utilisez l'expression :
-
Interroger les Métriques avec PromQL (Prometheus) :
- Dans le même menu Explore, basculez la source sur Prometheus.
- Saisissez la requête de consommation mémoire des conteneurs :
- Cliquez sur Run query : Grafana trace instantanément la courbe d'empreinte mémoire de vos microservices en direct !
5. Importer un Dashboard Prêt à l'Emploi depuis la Marketplace Grafana
Construire un tableau de bord complet panneau par panneau prend du temps. En entreprise, la communauté DevOps s'appuie sur la Grafana Marketplace (des milliers de dashboards partagés prêts à l'emploi identifiés par un numéro d'ID unique).
Méthode A : Import en 1 clic via l'ID de la Marketplace (Recommandé)
- Dans le menu de navigation de gauche, cliquez sur Dashboards, puis sur le bouton bleu New en haut à droite → sélectionnez Import (ou ajoutez le chemin
/dashboard/importdans l'URL de votre session Grafana). - Dans le champ Import via grafana.com, saisissez l'identifiant du tableau de bord officiel de référence :
- Dashboard ID
315: Kubernetes cluster monitoring (via Prometheus) — le dashboard communautaire le plus téléchargé au monde pour visualiser les conteneurs, les nœuds et les métriques cAdvisor. - (Alternative moderne) : Dashboard ID
15759(Kubernetes / Views / Pods). - (Pour les logs centralisés) : Dashboard ID
13639(Loki Kubernetes Pod Logs). - Cliquez sur le bouton bleu Load.
- Dans le formulaire qui s'affiche, associez la source demandée :
- Pour le champ Prometheus, sélectionnez votre source pré-configurée
Prometheus. - Cliquez sur Import : Le tableau de bord complet s'affiche instantanément avec ses jauges globales de processeur, sa consommation mémoire, ses débits réseau et son filtre par Namespace/Pod !
Méthode B : Import direct du fichier JSON (Environnement Hors-Ligne / Clé en Main)
Si votre navigateur ou votre cluster n'a pas d'accès direct vers l'extérieur pour joindre grafana.com :
- Sur la page d'importation de Grafana, cliquez sur Upload dashboard JSON file.
- Sélectionnez le fichier préparé dans votre répertoire de formation :
labs/06-exploitation-debugging/monitoring/dashboard-kubernetes.json(Ou ouvrez ce fichier, copiez son contenu texte et collez-le directement dans la zone de texte sous « Import via panel json »). - Cliquez sur Load puis Import : Vous visualisez instantanément le tableau de bord sur-mesure Campus Summer Portal - Monitoring & Logs Unifies, affichant à la fois les courbes métriques de vos pods et les logs Loki en temps réel côte à côte !
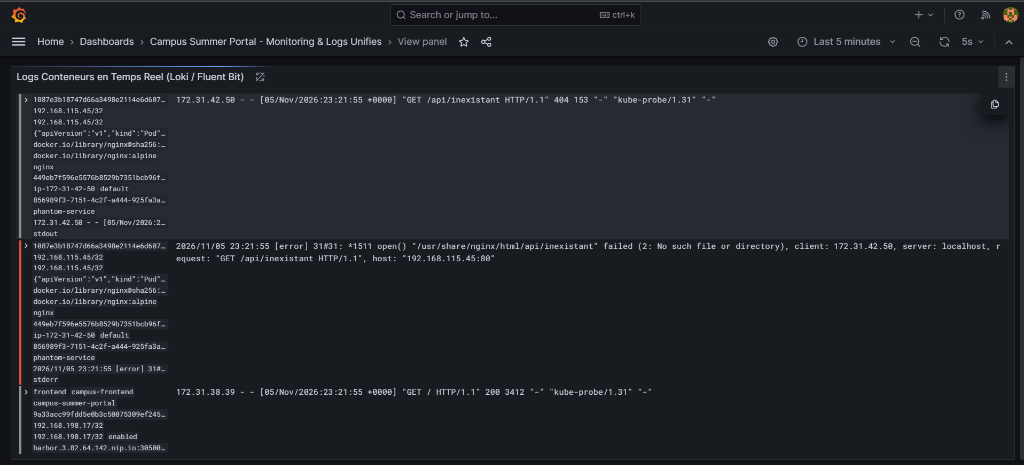
💡 Astuce LogQL : Mise en forme lisible des logs conteneurs
Cette directive
Par défaut, Fluent Bit encapsule les entrées dans un objet JSON enrichi avec les métadonnées Kubernetes. Pour afficher le corps du message en texte clair et faire ressortir les erreurs en rouge (stderr) et le flux standard en gris (stdout), vous pouvez éditer la requête du panneau avec le filtre suivant :| jsondécode l'objet etline_format "{{.log}}"extrait le message exact, facilitant grandement la détection d'incidents (comme l'erreur 404 du podphantom-servicevisible sur la capture ci-dessus).
Critères de Validation (Checklist)
- Les probes
livenessetreadinesssont configurées et comprises surcampus-backend. - Vous savez extraire les logs d'un crash passé avec l'option
kubectl logs --previous. - Vous avez diagnostiqué avec méthode les causes de
CrashLoopBackOff,OOMKilledetNotReady. - Vous avez déployé Node Problem Detector (NPD) et testé la mise en quarantaine d'un nœud avec
kubectl cordonetdrain. - Le Metrics-Server est opérationnel et vous maîtrisez
kubectl top nodesetkubectl top pods. - La pile CNCF Fluent Bit, Loki, Prometheus et Grafana est déployée dans le namespace
monitoring. - Vous avez importé avec succès un tableau de bord officiel depuis la Marketplace Grafana (Dashboard ID
315ou fichier JSON) unifiant métriques et flux de logs.